来源:米兰体育app官网入口下载 发布时间:2026-09-25 20:12:54
米兰体育app下载与安装:
前段时间,雷科技 WAIC2026 报导团亲赴现场,近间隔调查了这场全球 AI 大展,也看到了一场规划空前的人形机器人成人礼。
超越 200 家机器人相关企业、300 多台真机同台竞技——从宇树三米高的载人变形机甲来回切换形状,到智元的机器人用镊子夹起 2 毫米电阻焊到电路板上。曩昔最简略围住观众的后空翻和机械舞还在,但厂商越来越想证明另一件事:
但造出一副能跑、能跳、能伸手的「身体」,现已不是当下最稀缺的才能。实在的瓶颈是「大脑」,是怎样让机器人看懂紊乱的环境,决议下一步做什么,再把决议安稳地送到几十个关节。
就在 WAIC 完毕一周多后,Google DeepMind 推出了 Gemini Robotics 2,一个主打「全身智能」的机器人通用模型,适用于各种不同形状的机器人。
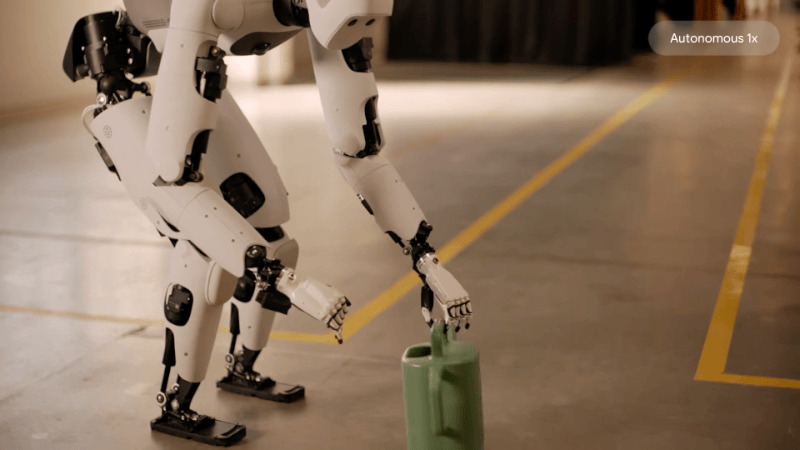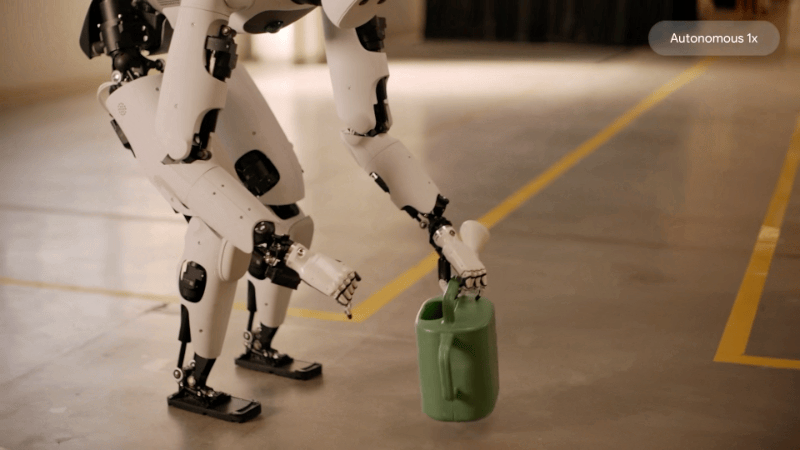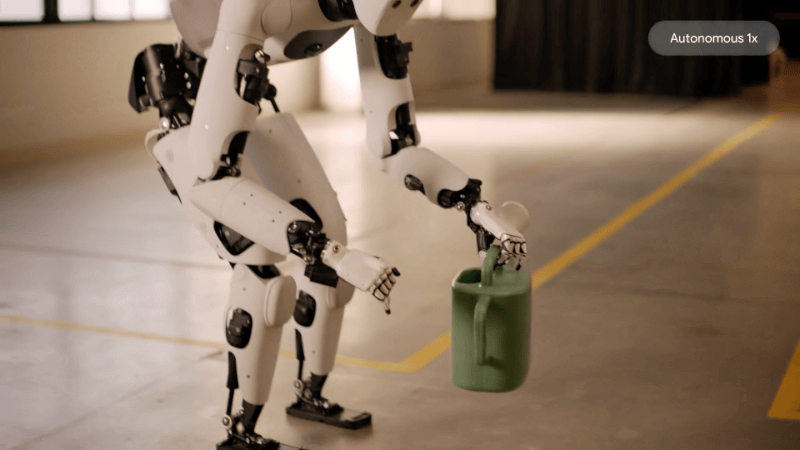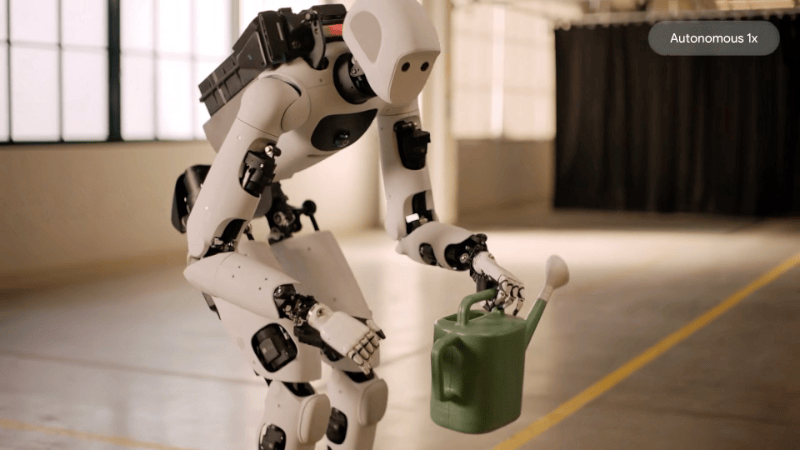
但最重要的关键词仍是「全身智能」。人类折腰捡起地上的水壶,会自然地前倾、屈膝、伸手,一起调整重心。封一只自封袋,会自然地对齐两边封口,再用手指从一端捏到另一端,还会依据塑料的形变随时调整力度。机器人却要接连算对一串互相操控的动作。
而谷歌这次的发布包括三个模型。Gemini Robotics ER 2 担任了解环境、规划长使命和与人交流,Gemini Robotics 2 这个 VLA 模型把视觉与言语直接转成动作,On-Device 2 则把动作模型压到本地,并能用少于 200 个样例、几小时数据适配新的机器人本体。
但中心在于,谷歌开端用一组模型和谐一台人形机器人的双腿、躯干、双臂和手指,让它一边考虑推理,一边移动操作。
曩昔不少机器人演示,都有一种很强的回合制游戏感。机器人先走到桌边、停下、站稳,然后调用机械臂抓取物体。抓完今后,它再次切换到行走操控器,去往下一个方位。每一段动作都能够做得很美观,但只需桌子偏了一点、物体滑了一下,或许它有必要边走边保持抓握,几个独立模块的接缝就会露出来。
上一代 Gemini Robotics 也首要操控机器人的上半身,处理桌面使命。到了 Gemini Robotics 2,官方视频中的 Apptronik Apollo 2 会走向放在地上的绿色水壶,折腰把它提起来。另一段画面中,Apollo 2 走到货架前,取出一只棒球手套,随后回身脱离。
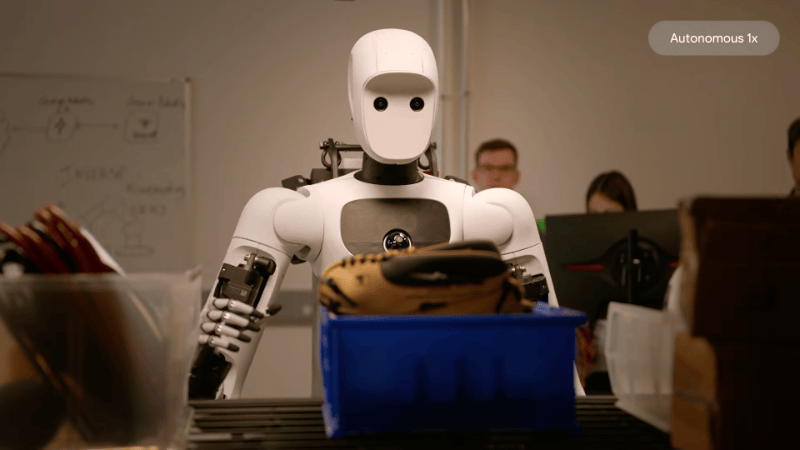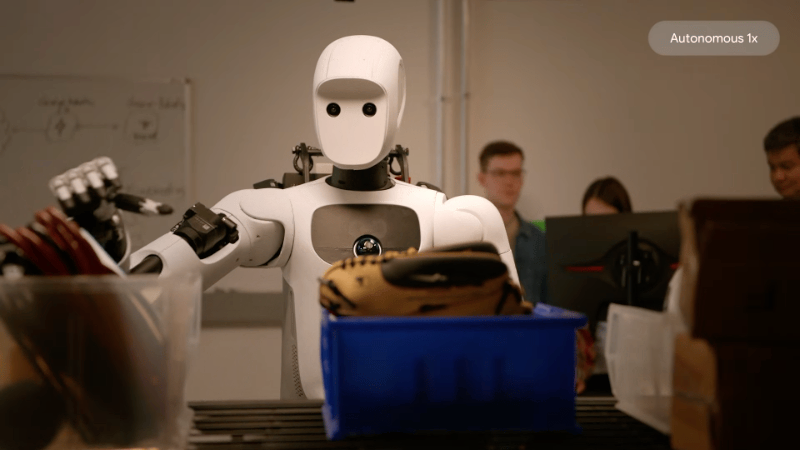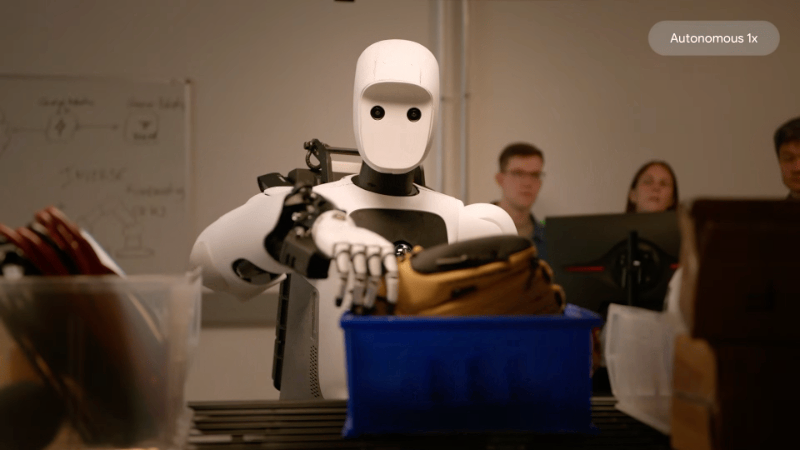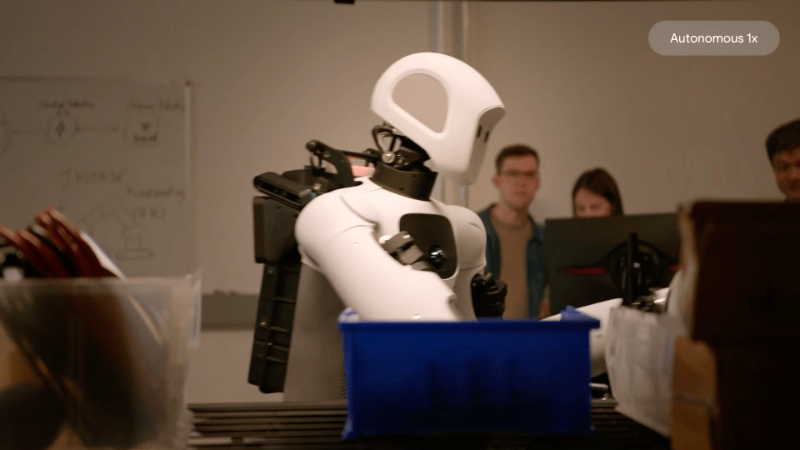
这些动作看起来平平无奇,背面却一起依靠视界、可达规划、步态和重心。手臂伸得更远,身体就要跟着前倾。身体前倾,双腿又有必要及时补偿。
这也是「全身」的实践意义:模型不再把腿当运输东西、把手当作业东西,而是把整副身体视为一个互相耦合的动作空间。谷歌称,同一个模型现已用于搭载不同灵活手的 Apollo 2,以及运用两指夹爪的 Franka Duo。至少在技能方向上,它想做的不仅仅一颗适配某款人形机器人的专用大脑。
当然,演示也没有快到让人发生幻觉。Apollo 走路、下蹲和摆放物体的速度都很慢,谷歌自己也供认移动速度仍需进步。官方测验中,Apollo 从桌面、地上和货架取物的均匀成功率别离为 68.4%、45.7% 和 76.3%。最能体现全身操控的地上取物,刚好也是成功率最低的一项。
全身操控处理的是机器人怎样抵达、怎样站稳。实在决议它能不能进入家庭和工厂的,往往仍是最后几厘米。
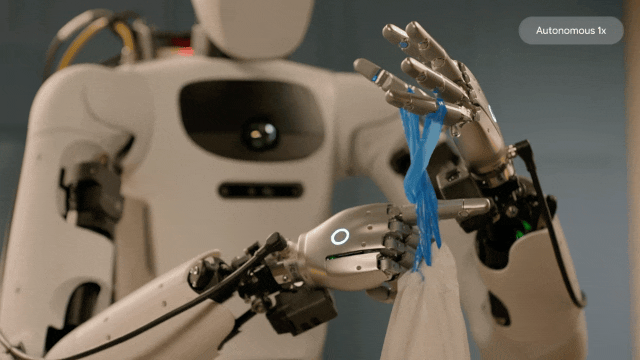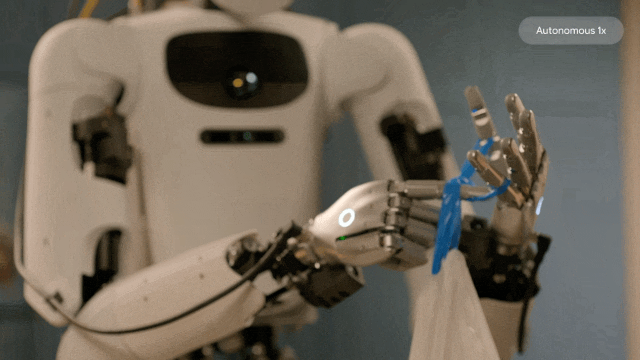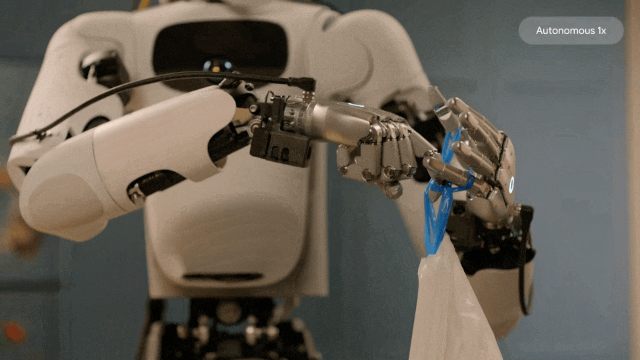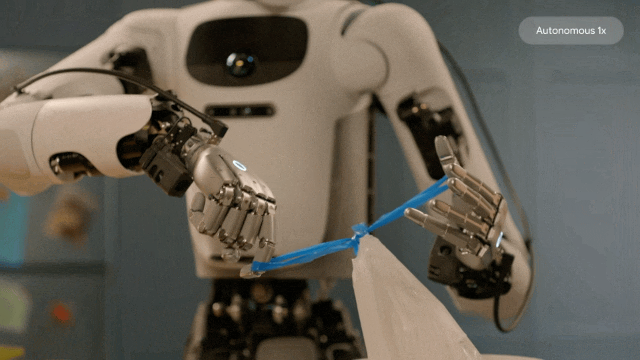
在官方视频里,Apollo 2 运用一只具有 22 个自由度的五指 SharpaWave 灵活手,测验拧灯泡、封自封袋、给垃圾袋打结。另一边,Franka Duo 的两只夹爪担任把形状各异的东西严密装进东西箱。
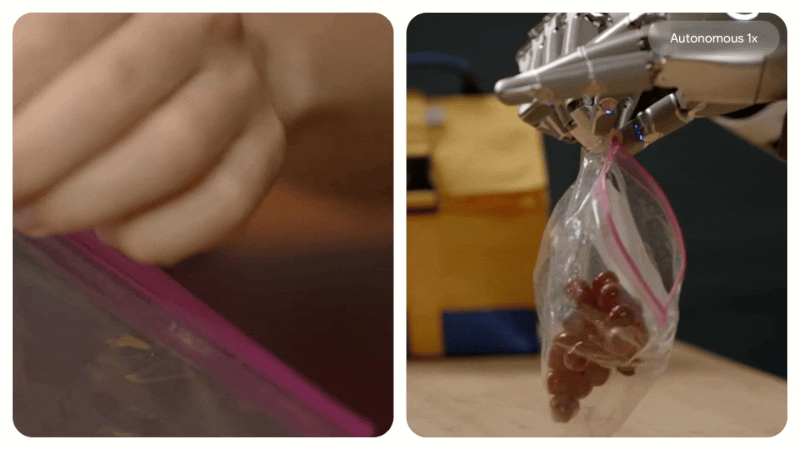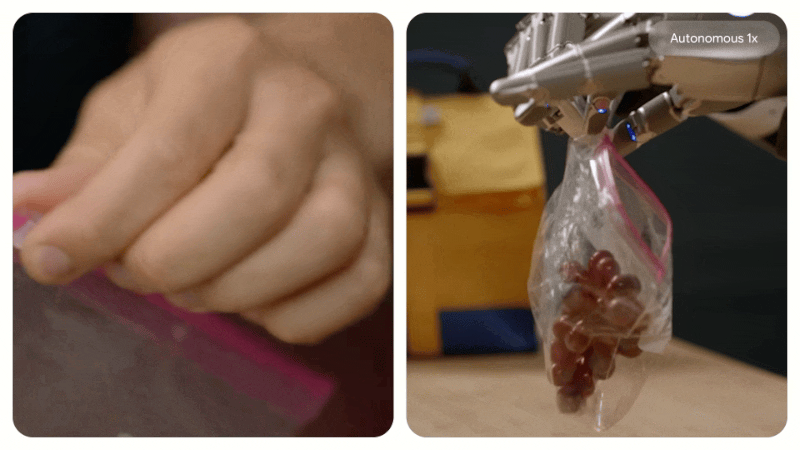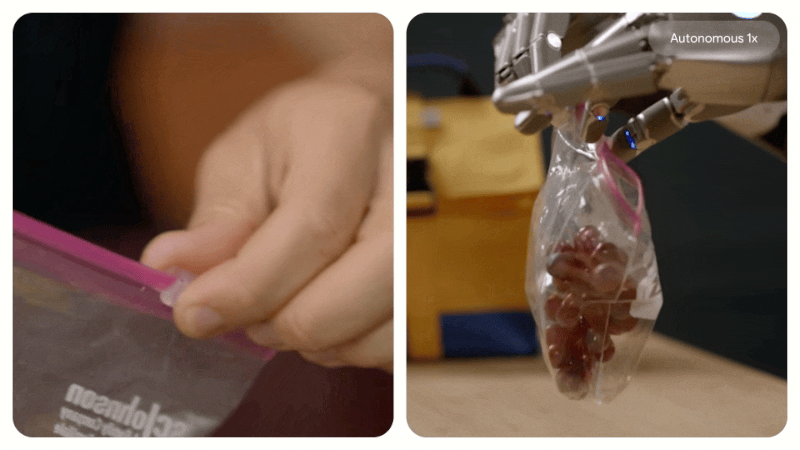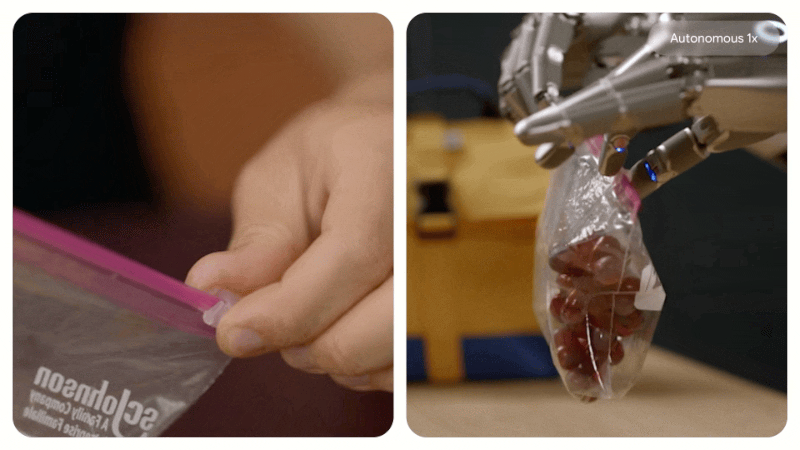
曩昔机器人最常见的抓取演示,往往仅仅把一个硬物从 A 点搬到 B 点。这些使命却触及接连触摸、双手配合和形变:塑料袋会塌,绳结会滑,灯泡既要对准螺纹,又不能捏得太用力。
人类做这些事时,不会先想好 22 个关节各自旋转多少度。Gemini Robotics 2 要做的,正是从视觉和指令直接生成这些高频、接连的动作。
不过谷歌发布的成果也很老实。两指夹爪在通用抓放、东西配套和精密刺进上的均匀成功率到达 74.2%、78.9% 和 89.6%,到了多指灵活手,间隔敏捷摆开:拧下灯泡到达 92%,拧上灯泡只需 36%,扎垃圾袋是 44%,运用簸箕和封自封袋别离只需 32% 和 40%。
这组数字也阐明晰大模型现已能接收适当杂乱的手部动作,而多指灵活操作远未到达官方模型页面所说的「人类级」。至少现在,机器人拧灯泡依然或许十次失利六次。
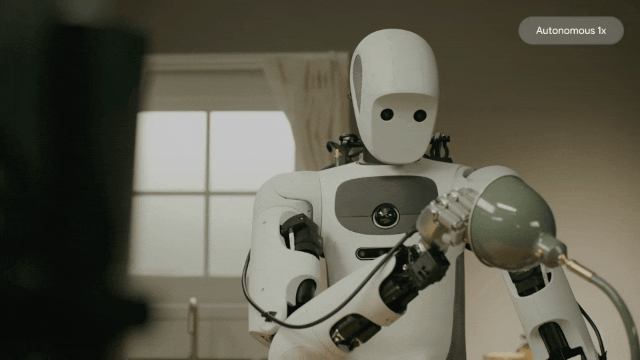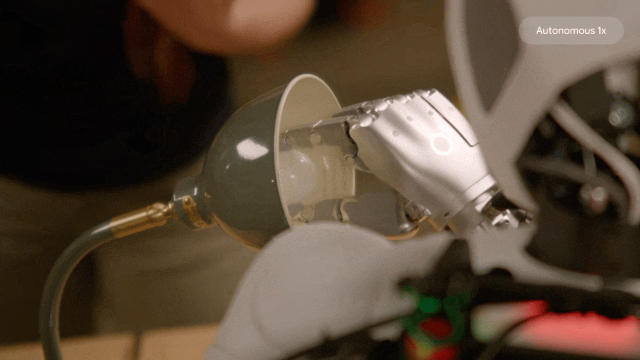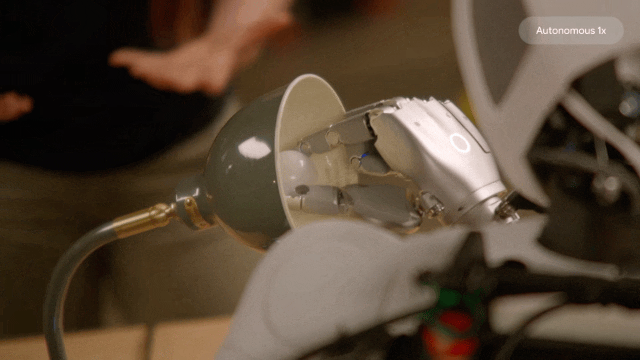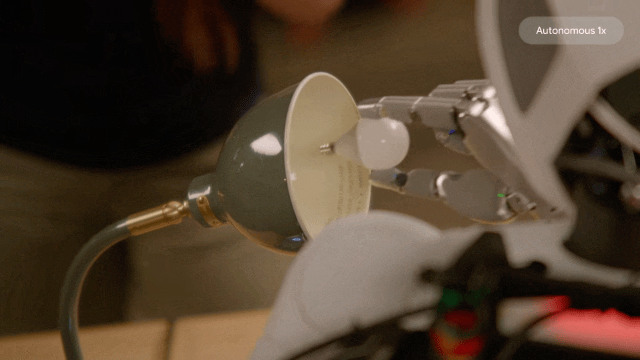
第三个改动是协作。视频中,Apollo 与 Franka Duo 一起拾掇东西箱。Apollo 宣布使命,Duo 把东西装入盒内,两台机器人各自运转一套模型,通过高层推理分配和联接作业,而不是由一个中心神经网络一起操作两副身体。ER 2 还会继续检查视频,判别使命进展、发现失利并决议是不是重试。
这和两台机器人机械地履行预设工序不太相同。谷歌想让不同形状的机器人先了解互相拿手什么,再像团队相同交代使命。仅仅官方视频展现的是一个通过规划、总长几分钟的东西收纳场景,离多台机器人在实在工厂里接连协作几个月,还隔着很长的安稳性验证。
具身智能职业现在遍及将机器人架构归纳成「大脑」和「小脑」。大模型担任看懂指令、拆解使命,小模型和传统操控器担任导航、平衡、抓取。这样做很务实:高层推理不需求每秒运转数百次,底层操控也不能等一个大模型渐渐考虑。模块分隔,布置、调试和安全兜底都更简略。
抬起一个重物会改动平衡,向前跨步会改动手臂的可达规划,手里的杯子一滑,本来的途径规划立刻报废。高层方案与底层动作只需了解不一致,过错就会在长使命中累积。每次从行走切换到抓取、从抓取切回导航,也或许带来中止。机器人分明方案对了,身体却没有照做。
但严格来说,谷歌并没抛弃「大小脑」。ER 2 依然是高层大脑,担任看、想、规划和调用东西,再把动作履行交给 VLA。它还能够把导航 API、机械臂接口和其他厂商的 VLA 当成东西。
谷歌处理的,是在动作层继续把走路、平衡、躯干和手臂切成一堆互不相干的小脑。Gemini Robotics 2 用一个 VLA 一致全身动作,ER 2 则能够一边调查履行,一边考虑后续过程,削减机器人每做一步都要「停下来想想」的分裂感。
这也解说了谷歌为什么没有把全部环节都塞进一个巨型网络。机器人底层操控寻求毫秒级呼应,高层推理却或许要检索材料、了解人类迷糊的要求。两者需求的算力、数据和运转频率都不同。悉数揉在一起,练习成本会敏捷上升,出了问题也很难判别究竟是方案错了,仍是关节没有履行到位。
更实际的是安全。模型能够决议把水壶放到货架,急停、限速和人与机器人的安全间隔却不能只靠概率确保。ER 2 引进安全束缚、可行性判别和恳求人类介入,底层仍保存传统物理安全机制,阐明谷歌也没有计划让端到端学习包揽全部。
并且这条道路也不是谷歌独有。Figure 在今年初发布的 Helix 02,相同把全部传感器接入一个全身视觉运动战略,让 System 1 以 200Hz 输出全身关节方针,再由 System 0 以 1kHz 处理平衡和触摸,最上层的 System 2 继续担任语义推理。看起来像一个模型,内部仍是按不一起间尺度严密咬合的三层体系。
智元最新的 GO-2 也直接把问题称为「语义—履行间隔」,用动作思想链与异步双体系衔接低频规划和高频履行。咱们并没有简略地在「一个模型」和「大小脑」之间二选一,而是在缩短模块之间传话的间隔。
现在具身智能模型的前沿探究,大致都在追三件事:更多本体、更长使命和更少的专用数据。英伟达开源的 GR00T N1.6 吃进了数千小时遥操作数据,现已在智元 Genie-1、宇树 G1 和不同双臂渠道上进行后练习,并把全身移动操作归入数据集。
Physical Intelligence 的 π0.5 则混合不同机器人、网页常识和高层子使命数据,让轮式双臂机器人在生疏住所里接连整理厨房和卧室,使命时长到达 10 到 15 分钟。而蚂蚁灵波开源 LingBot-VLA 2.0,用 6 万小时数据掩盖 20 种机器人构型,还把手臂、灵活手、腰、头和移动底盘映射进一致动作空间。
这些都越来越像大言语模型前期的竞赛:先用多使命、多本体数据练习一套根底才能,再花少数数据适配详细硬件和场景。Gemini Robotics On-Device 2 用不到 200 个样例适配新本体,最需求咱们来重视的也在这里。假设换一副机械臂、换一套传感器都要从头收集海量数据,所谓通用模型就很难构成规划效应。
但机器人比谈天模型更难欺骗。英伟达在 GR00T N1.6 的阐明中仍供认,多使命言语跟和顺散布外泛化是继续应战。谷歌的五指使命成功率也清楚标明,同一个模型能操控不同身体,不等于它现已安稳把握全部身体。更甭说实在布置还需求面临磨损、电量、磕碰、人类忽然闯入和网络中止。
所以,Gemini Robotics 2 最重要的当地,不是给机器人装上了一颗忽然开窍的大脑,是在于让具身智能模型开端跳过桌面和上半身,把走路、平衡、精密操作、长使命与多机协作放进同一张考卷。相较之下,之前一种使命对应一组算法的做法,更接近前大模型年代的 AI。
与此一起,WAIC 上那些越来越老练的芯片、关节和整机,现已为 AI 预备了许多副身体。谷歌这次企图证明,模型也开端学会把身体当作一个全体来运用。至于它何时能实在走进咱们的厨房,折腰捡起掉在地上的杯子,随手擦干洒出的水,再在咱们回家前把房间拾掇好——那不只需求全身智能。
Copyright©2019 备案号:鲁ICP备19017685号 技术支持:米兰体育app官网入口下载 网站地图